Traitement de l'IA en temps réel Pourquoi la latence est la clé pour HiSilicon
Pour les SoC HiSilicon AI, la faible latence est la mesure de performance la plus critique. Ce matériel se concentrer sur les performances de faible latence e
Pour les SoC HiSilicon AI, la faible latence est la mesure de performance la plus critique. Cette focalisation matérielle sur les performances à faible latence permet le traitement des données en temps réel. La croissance du marché de l'IA à un projeté143 milliards d'ici 2034Met en évidence la demande pour ces performances matérielles. Dans les systèmes où la latence compte,Un retard de plus de 100 millisecondes dégrade les performances de sécurité. L'architecture matérielle spécialisée de HiSilicon donne la priorité à cette performance de latence de bout en bout. Cette conception matérielle assure une performance supérieure de l'IA dans le monde réel.Les TOPS bruts ne reflètent pas les vraies performances matérielles. Cette focalisation du matériel sur les performances de latence est essentielle pour les performances matérielles de l'IA, car le matériel lui-même est au cœur des performances matérielles de l'IA.
Les clés à emporter
- La faible latence est très importante pour les puces IA de HiSilicon. Cela signifie que lePucePrend des décisions rapidement, ce qui est essentiel pour les tâches en temps réel.
- La conception spéciale de HiSilicon, appelée Da Vinci NPU, aide les modèles d'IA à fonctionner rapidement. Il utilise un cube 3D unique pour faire des mathématiques rapidement.
- Pièces spéciales dans lePuce, Comme le processeur de signal d'image, aider la partie principale de l'IA. Ils rendent l'ensemble du système plus rapide en effectuant des tâches spécifiques.
- Le traitement rapide de l'IA aide les voitures autonomes, les villes intelligentes et les appareils intelligents. Cela les rend plus sûrs et fonctionnent mieux dans la vie réelle.
POURQUOI LA LATENCE compte dans EDGE AI
Dans les applications Edge AI, chaque milliseconde compte. Le système doit traiter les flux de données en temps réel, où le retard peut entraîner des événements manqués ou des actions incorrectes. C'est pourquoi la latence est importante. Les algorithmes de contrôle dépendent de décisions d'inférence immédiates pour maintenir la stabilité et la sécurité. Un retard peut compromettre les performances de l'ensemble du système.La vraie performance matérielle ne concerne pas seulement la puissance de traitement; il s'agit de la vitesse de la sortie finale exploitable.
DÉFINIR LA LATENCE DE TRAITEMENT DE L'IA
Les professionnels définissent formellement la latence d'inférence de l'IA comme le temps nécessaire à un modèle d'IA pour recevoir une entrée et renvoyer une prédiction. Cette mesure est typiquement exprimée en millisecondes (ms).Cependant, la latence de bout en bout fournit une image plus complète des performances du système. Il couvre l'ensemble du parcours, de la capture des données à l'action finale.
Cette latence totale comprend plusieurs étapes distinctes:
- Ingestion et prétraitement des donnéesLe matériel prépare d'abord les données d'entrée. Cette étape consiste à formater et à valider les données avant d'atteindre les modèles d'IA.
- Modèle Inférence: C'est le temps de calcul principal. Le matériel exécute les modèles d'IA pour générer une prédiction basée sur les données d'entrée. La performance d'inférence ici est critique.
- Post-traitement et sortie: Le matériel formate la sortie du modèle. Il prépare le résultat pour le prochain composant du système, tel qu'un contrôleur de bras robotisé ou un affichage.
Remarque:Pour l'IA interactive, d'autres métriques mettent également en évidence les performances matérielles.Temps jusqu'au premier jeton (TTFT)Mesure la rapidité avec laquelle un utilisateur obtient le premier élément d'une réponse, ce qui est essentiel pour une expérience utilisateur fluide.
LIMITATIONS DU CUS À USAGE GÉNÉRAL
Les CPU à usage général ne sont pas conçus pour répondre aux exigences de l'IA moderne.Les processeurs utilisent un petit nombre de cœurs puissants, généralement entre 4 et 64. Cette architecture excelle dans les tâches complexes et séquentielles. Cependant, les modèles d'IA nécessitent des calculs massivement parallèles, exécutant des milliers d'opérations simples à la fois. Cette inadéquation crée un goulot d'étranglement significatif en termes de performances.La conception de la CPU limite ses performances d'inférence pour les charges de travail parallèles.
Même dans les systèmes dotés d'un GPU puissant, le CPU peut limiter les performances globales, en particulier dans les applications sensibles à la latence.Le CPU a du mal à fournir des données à l'accélérateur assez rapidement, ce qui nuit aux performances d'inférence du système. C'est pourquoiMatériel spécialiséEst nécessaire pour une performance AI optimale.
Les benchmarks montrent clairement l'écart de performance entre les CPU et le matériel spécialisé commeUnités de traitement neuronal(NPU). Pour les modèles d'IA courants comme YOLOv3, les NPU offrent des performances d'inférence bien meilleures.
| Type de système | Réduction de latence relative |
|---|---|
| Système CPU-Only | Base de référence |
| Système alimenté par NPU | ~ 1.6x plus rapide |
Ces données montrent que le matériel dédié réduit considérablement le temps nécessaire pour exécuter des modèles d'IA. L'avantage architectural des NPU se traduit directement par une latence plus faible et des performances d'inférence supérieures. Le graphique ci-dessous illustre en outre comment différentes plates-formes matérielles spécialisées atteignent une latence variable pour les modèles d'IA populaires.
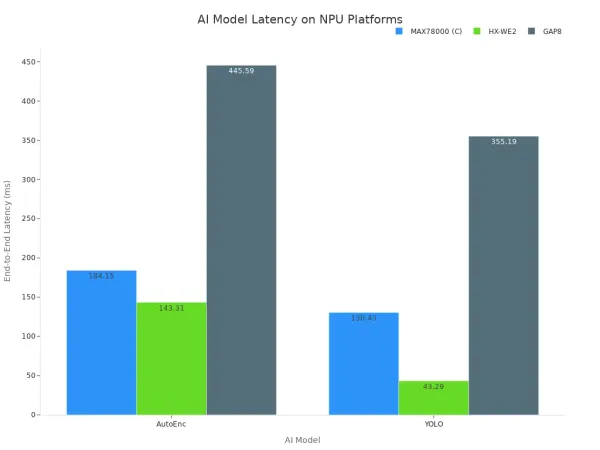
En fin de compte, s'appuyer sur les CPU pour les tâches d'IA en temps réel compromet la réactivité du système. Le matériel n'est tout simplement pas conçu pour le travail. Atteindre la faible latence qui compte nécessite un matériel spécialement conçu pour les modèles d'IA, garantissant des performances et une fiabilité d'inférence de haut niveau.
ARCHITECTURE DE HISILICON POUR FAIBLE LATENCE
HiSilicon atteint ses performances de faible latence à la pointe de l'industrie grâce à une architecture matérielle holistique. Cette conception va au-delà d'un seul processeur puissant. Il intègre des noyaux de calcul spécialisés, un haut débitMémoireSystème et des accélérateurs matériels dédiés. Cette combinaison garantit que les données se déplacent et sont traitées avec une efficacité maximale, ce qui est essentiel pour les applications d'IA en temps réel. La performance globale du système dépend de cette intégration étroite.
LE NOYAU DE LA NPU DA VINCI
L'unité de traitement neuronal Da Vinci (NPU) est le cœur du matériel d'IA de HiSilicon. Ce NPU est un puissant accélérateur d'IA conçu spécifiquement pour les opérations mathématiques qui alimententModèles d'IA modernes. Son architecture n'est pas uniforme; il combine différents types d'unités de calcul pour optimiser les performances. CeciConception hétérogèneEst une raison clé de son excellente performance d'inférence.
Le noyau contient trois composants principaux qui travaillent ensemble:
- Unités scalairesCeux-ci gèrent la logique générale et le flux de contrôle pour les modèles d'IA.
- Unités de vecteurCeux-ci sont excellents pour exécuter de nombreuses opérations simples à la fois, un besoin commun pour certaines couches dans les modèles d'IA.
- Unités de cube 3DC'est le composant le plus critique pour l'accélération de l'IA. Ces unités sont construites pour effectuer la multiplication de matrice aux vitesses incroyables.
Cette structure permet au noyau Da Vinci de traiter des modèles d'IA complexes avec un retard minimal. Les unités de cube gèrent le levage lourd des mathématiques matricielles, tandis que les unités vectorielles et scalaires gèrent les tâches environnantes. Cette division du travail à l'intérieur de l'accélérateur d'IA garantit qu'aucune partie du matériel ne crée un goulot d'étranglement. Il en résulte des performances d'inférence supérieures et une latence plus faible pour les charges de travail IA exigeantes. Ces accélérateurs d'IA sont essentiels à la performance globale du système.
MÉMOIRE SUR PUCE ET INTERCONNEXIONS
Un NPU rapide a besoin de données rapides. Si l'accélérateur d'IA doit attendre les données, son avantage de performance est perdu. La conception matérielle de HiSilicon répond à ce défi avec une hiérarchie de mémoire sophistiquée sur puce et des interconnexions à haute vitesse. Ces composants créent une autoroute de données, minimisant la latence associée au déplacement d'informations autour de la puce. Ce flux de données efficace est essentiel pour les performances d'inférence du matériel.
Les SoCs HiSilicon utilisent des interconnexions avancées pour relier le NPU, le CPU et la mémoire. Cela garantit que tous les composants peuvent communiquer avec un retard minimal. Le choix de la technologie de la mémoire joue également un rôle essentiel dans les performances du système.
| Modèle de puce | Interconnexion | Technologie de mémoire |
|---|---|---|
| Kirin 960 | CCI-550 BRAS | LPDDR4-1600 (double canal 64 bits) |
| Kirin 970 | CCI-550 BRAS | Liste des pièces LPDDR4 |
Au-delà de la mémoire principale, le système utilise plusieurs couches de mémoire sur puce (caches). Le Da Vinci NPU lui-même contient sa propre mémoire locale. Cela permet à l'accélérateur d'IA de conserver les données fréquemment utilisées pour les modèles d'IA juste à côté des unités de calcul, réduisant ainsi considérablement la latence d'accès aux données. Cette architecture améliore également l'efficacité énergétique.Un flux de données efficace sur puce, souvent géré par un réseau sur puce (NoC), réduit la consommation d'énergie en envoyant des données dans des paquets flexibles. Cette approche réduit le nombre de fils physiques et améliore les performances.D'autres techniques améliorent encore cette efficacité:
- Gating à grain finCette méthode utilise l'horloge gating pour réguler le flux de données entre les unités matérielles.
- Mise en mémoire tamponLes tampons explicites (FIFO) garantissent que les données sont disponibles précisément lorsque l'accélérateur d'IA en a besoin, évitant ainsi les décrochages et le gaspillage d'énergie.
ACCÉLÉRATION DU MATÉRIEL DÉDIÉ
Le NPU est le joueur vedette, mais ce n'est pas le seul accélérateur matériel de l'équipe. Les SoC HiSilicon intègrent une suite d'accélérateurs matériels dédiés qui gèrent des tâches spécifiques. Ces accélérateurs déchargent le travail du CPU et du NPU, réduisant ainsi la latence de bout en bout de l'ensemble du pipeline d'IA. Cette approche est essentielle pour des tâches complexes telles que l'analyse vidéo en temps réel et permet une inférence efficace sur l'appareil.
Dans les applications de vision par ordinateur, laProcesseur de signal d'image (ISP)Est un accélérateur matériel crucial. L'ISP travaille directement avec le NPU pour fournir de meilleures performances d'inférence.
- Le FAI gère les tâches initiales de traitement de l'image telles que la fusion HDR (High Dynamic Range) et la réduction avancée du bruit.
- Il prépare et optimise les données vidéo spécifiquement pour les modèles d'IA fonctionnant sur le NPU.
- Ce prétraitement par un accélérateur matériel dédié signifie que le NPU reçoit des données propres et prêtes à analyser, ce qui accélère le résultat final de l'IA.
De même, les encodeurs et décodeurs vidéo matériels sont des accélérateurs d'IA essentiels pour l'analyse de flux vidéo haute résolution. Ces accélérateurs gèrent l'ensemble du pipeline de traitement vidéo sur une seule puce.
- Ils décodent les flux vidéo entrants sans alourdir le CPU.
- Ils permettent au NPU d'analyser la vidéo localement.
- Ils ne transmettent que des données d'événements critiques, ce qui réduit considérablement la bande passante du réseau et les coûts de stockage.
Cette équipe d'accélérateurs matériels spécialisés veille à ce que chaque étape d'une tâche d'IA, de la capture de données à la sortie finale, soit optimisée pour la vitesse. Cette approche globale de la conception matérielle est ce qui donne à HiSilicon son avantage en matière de performances à faible latence pour l'IA en temps réel. La synergie entre ces accélérateurs offre un niveau de performance qu'un seul processeur ne peut égaler.
APPLICATIONS À FAIBLE LATENCE DANS LE MONDE RÉEL
Le matériel à faible latence déverrouille une nouvelle génération de systèmes intelligents. La performance de ces systèmes dépend du traitement immédiat des données. L'architecture matérielle de HiSilicon fournit la vitesse nécessaire pour les applications critiques d'IA dans le monde réel. La performance supérieure de ses modèles d'IA permet une prise de décision instantanée là où les millisecondes comptent.
SYSTÈMES AUTONOMES
Dans les systèmes autonomes, une faible latence est une exigence non négociable en matière de sécurité et de précision. Le matériel doit traiterCapteurDonnées et exécuter des modèles d'IA avec un retard minimal pour assurer des performances fiables.
- Véhicules autonomesPour une voiture autonome, détecter un piéton et appliquer les freins nécessite uneLatence de bout en bout de 50 à 100 millisecondes. Tout retard au-delà de cela compromet la sécurité. Le matériel du véhicule doit fournir cette performance de manière cohérente.
- Robotique industrielle: Sur unAssembléeEn ligne, les robots ont besoin d'une rétroaction rapide pour effectuer des tâches précises.Cycles d'exécution Sub-100msPour les modèles d'IA permettentUn meilleur contrôle de la qualité et une meilleure sécurité des travailleurs. Cette performance matérielle à faible latence améliore directement le débit de fabrication.
INFRASTRUCTURE INTELLIGENTE
Les villes et usines intelligentes utilisent l'analyse de l'IA à la caméra pour améliorer l'efficacité et la sécurité. Cela nécessite un matériel de périphérie puissant capable de traiter les flux vidéo en temps réel. La performance de ces modèles d'IA est la clé de leur succès.
Détection des menaces en temps réel:Dans les villes intelligentes, les caméras d'IA surveillent les espaces publics. Le matériel analyse les flux vidéo versIdentifier les violations de la circulation, les objets abandonnés ou d'autres menaces potentielles, permettant une réponse immédiate. Cette performance d'IA aide les forces de l'ordre et optimise les services d'urgence.
Dans les usines intelligentes,Les systèmes de vision d'AI fournissent le contrôle de qualité instantané. Le matériel exécute des modèles d'inspection qui analysent les produits sur la chaîne de montage,Identifier les défauts comme les rayures ou les désalignements. Cette rétroaction immédiate améliore la qualité du produit sans ralentir la production. La performance des modèles d'IA est critique ici.
DISPOSITIFS ET MÉDIAS INTELLIGENTS
Le traitement IA à faible latence améliore l'expérience utilisateur dans l'électronique grand public et les appareils de santé. Le matériel permet des fonctionnalités sophistiquées qui s'exécutent directement sur l'appareil.
Utilisation des téléviseurs intelligentsModèles AI pour la mise à l'échelle vidéo 8K en temps réel. Le processeur AI du matériel analyse le contenu trame par trame pour améliorer les détails et réduire le bruit, Offrant une image supérieure. Cette performance de haut niveau se produit instantanément. Pour la télémédecine et les wearables,Matériel sur l'appareilAnalyse les données biométriques.Les modèles de détection d'événements d'urgence nécessitent une latence inférieure à 50 msPour alerter les utilisateurs ou le personnel médical. Cette performance rapide de l'IA peut sauver des vies.
Pour l'IA de périphérie en temps réel, la latence de bout en bout est importante.Le débit de calcul brut seul ne définit pas la vraie performance matérielle. L'architecture matérielle de HiSilicon, avec son NPU Da Vinci et ses accélérateurs matériels dédiés, offre cette performance critique à faible latence. La performance de ces accélérateurs matériels est essentielle. Les accélérateurs matériels offrent d'excellentes performances.
Note pour les développeurs:Vous devez comparer le matériel pour la latence. Cela garantit des performances et une fiabilité matérielles réelles. La latence est importante pour ces performances matérielles. Les accélérateurs matériels et le matériel fournissent cette performance. La performance des accélérateurs matériels est vitale. Les performances matérielles dépendent de ces accélérateurs matériels.
FAQ
Pourquoi la latence est-elle plus importante que TOPS pour l'IA edge?
TOPS mesure la puissance de traitement brute. La latence mesure le temps total d'une décision. Pour les applications en temps réel telles que la conduite autonome, une décision rapide est plus critique pour la sécurité et les performances qu'un simple débit de calcul élevé.
Une faible latence permet au système de réagir instantanément aux nouvelles informations.
Qu'est-ce que le Da Vinci NPU?
Le Da Vinci NPU est l'accélérateur spécialisé d'IA de HiSilicon. Il utilise une architecture 3D Cube unique pour les mathématiques matricielles. Cette conception accélère considérablement les calculs du modèle AI. Il réduit directement la latence d'inférence et améliore les performances globales du système pour les tâches en temps réel.
Comment les accélérateurs matériels améliorent-ils les performances de l'IA?
Les accélérateurs matériels, comme un processeur de signal d'image (ISP), gèrent des tâches spécifiques. Ils déchargent les tâches du processeur principal. Ce traitement parallèle réduit les goulets d'étranglement. L'ensemble du pipeline d'IA fonctionne plus rapidement, réduisant la latence de bout en bout et permettant une inférence efficace sur l'appareil.
Quelles applications nécessitent une latence ultra-faible?
Les applications nécessitant une action immédiate nécessitent une faible latence. Ces systèmes reposent sur une prise de décision rapide et en temps réel. Voici quelques exemples clés:
- Systèmes autonomes (véhicules, robotique)🤖
- Infrastructure intelligente (détection des menaces)🏙️
- Médias avancés (upscaling 8K)📺
- Télémédecine (alertes d'urgence)❤️🩹